Enjambres de robots entrenados por ensayo y error en simulación funcionan en la realidad
· Futuro
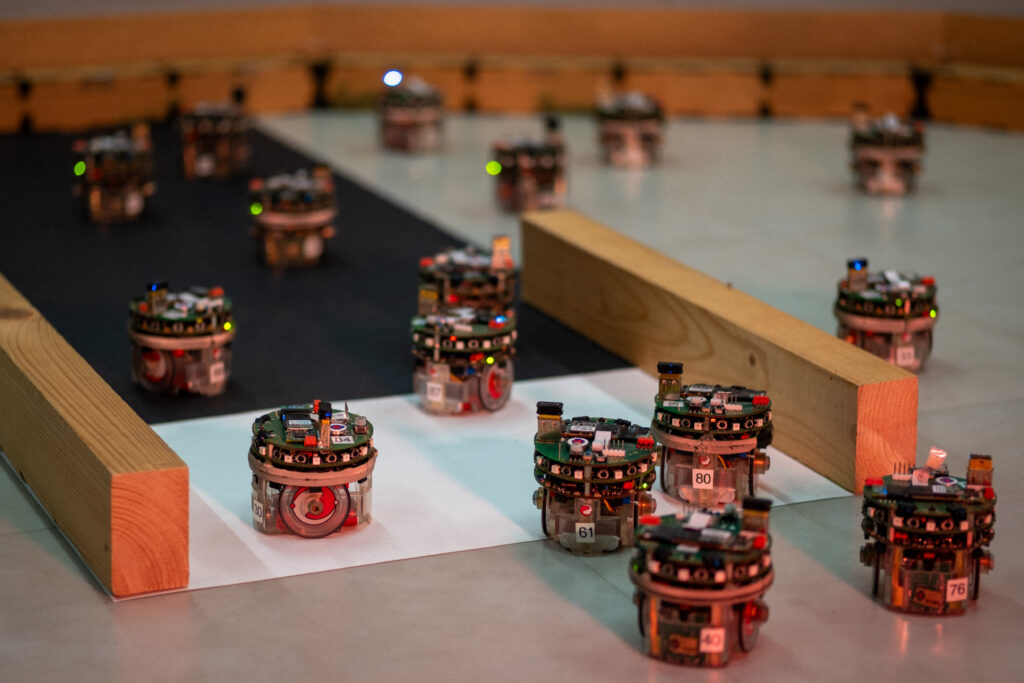
Investigadores de IRIDIA han desarrollado un método de aprendizaje para enjambres de robots que elimina la «brecha de realidad», permitiendo a los agentes de IA operar de forma estable en el mundo físico tras entrenarse en simulaciones.
Investigadores del laboratorio de inteligencia artificial IRIDIA de la Université libre de Bruxelles han desarrollado un método de aprendizaje para enjambres de robots que permite transferir con éxito las habilidades adquiridas en simulaciones a dispositivos reales. Los resultados del trabajo, publicados en la revista Science Robotics, demuestran cómo superar la llamada «brecha de la realidad» (reality gap), un problema por el cual los robots entrenados en entornos virtuales a menudo fracasan en condiciones físicas debido a diferencias en la fricción, el ruido de los sensores o errores mecánicos.
Limitar la libertad en favor de la estabilidad
Tradicionalmente, el aprendizaje por refuerzo permite que los robots dominen comportamientos complejos de forma autónoma; sin embargo, la excesiva flexibilidad de los algoritmos provoca que el sistema aprenda a explotar características específicas del simulador que no existen en la realidad. El equipo de científicos, dirigido por Mauro Birattari e Iliès Gherbi, propuso un enfoque que limita la libertad de acción del algoritmo: en lugar de controlar directamente los motores, la inteligencia artificial elige entre un conjunto restringido de comandos probados, como moverse hacia una fuente de luz, agruparse o explorar el territorio.
«Durante años hemos sostenido que la brecha de la realidad es, en esencia, un problema de sobreajuste: un método de diseño demasiado flexible acaba aprendiendo el simulador en lugar de la tarea», explicó Mauro Birattari.
Eficacia en la práctica
Como parte del estudio, los científicos realizaron 250 experimentos con un grupo de 20 robots e-puck, que llevaron a cabo cinco tareas colectivas diferentes. El enfoque superó significativamente al método más avanzado, en el que el algoritmo controla directamente los motores de los robots y que funcionaba mal tras el traslado a las máquinas reales. Curiosamente, las políticas más sencillas y limitadas se transfirieron mejor a los robots reales que las más grandes y flexibles, lo que contradice la intuición extendida en el ámbito de la inteligencia artificial sobre la superioridad de los grandes modelos.
Los autores consideran que este enfoque convierte al aprendizaje por refuerzo en una herramienta práctica para la robótica. Permite a los desarrolladores entrenar enjambres para nuevas misiones en simulación y desplegarlos con confianza en robots reales —desde labores de búsqueda y rescate tras terremotos hasta la monitorización del medio ambiente— en el espacio virtual, sin exponer a riesgos al equipo real.
«Lo que me entusiasma es que esto convierte al aprendizaje por refuerzo en una herramienta práctica para la robótica de enjambres», señaló Iliès Gherbi. El siguiente paso para el equipo será probar el método con un mayor número de robots y en condiciones menos controladas.
Basado en información de: Robohub
Adaptación al español con ayuda de inteligencia artificial. Читати українською