Рої роботів, навчені методом спроб і помилок у симуляції, успішно працюють у реальності
· Майбутнє
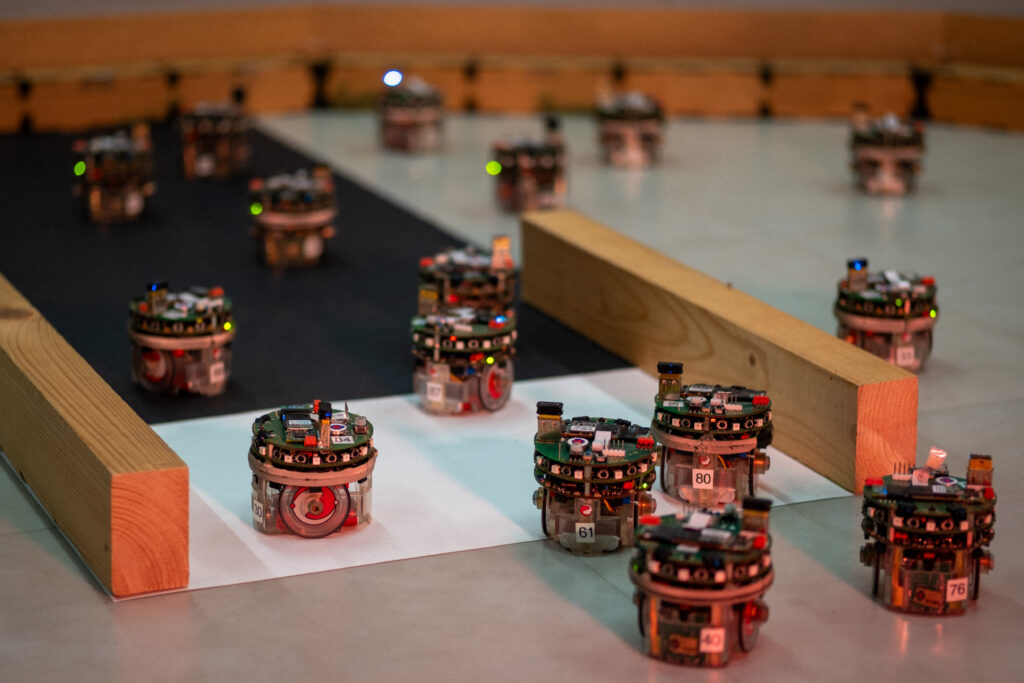
Дослідники з IRIDIA розробили метод навчання роїв роботів, який усуває «прірву реальності», дозволяючи ШІ-агентам стабільно працювати в фізичному світі після тренувань у симуляції.
Дослідники з лабораторії штучного інтелекту IRIDIA при Université libre de Bruxelles розробили метод навчання роїв роботів, який дозволяє успішно переносити навички, здобуті в симуляції, на реальні пристрої. Результати роботи, опубліковані в журналі Science Robotics, свідчать про подолання так званого «розриву з реальністю» (reality gap) — проблеми, через яку роботи, навчені у віртуальному середовищі, часто не справляються з фізичними умовами через відмінності у терті, шумі сенсорів чи механічних похибках.
Обмеження свободи заради стабільності
Традиційно навчання з підкріпленням дозволяє роботам самостійно опановувати складні поведінки, проте надмірна гнучкість алгоритмів призводить до того, що система вчиться експлуатувати специфічні особливості симулятора, які відсутні в реальності. Команда вчених під керівництвом Мауро Біраттарі та Ілієса Гарбі запропонувала підхід, що обмежує свободу дій алгоритму: замість прямого керування двигунами, штучний інтелект обирає з обмеженого набору перевірених команд, таких як рух до джерела світла, об’єднання в групи або дослідження території.
«Протягом багатьох років ми стверджували, що розрив із реальністю — це, по суті, проблема перенавчання: метод дизайну, який є занадто гнучким, вивчає симулятор, а не завдання», — пояснив Мауро Біраттарі.
Ефективність на практиці
У межах дослідження вчені провели 250 експериментів із групою з 20 роботів e-puck, які виконували п'ять різних колективних завдань. Підхід суттєво перевершив найсучасніший метод, у якому алгоритм безпосередньо керує моторами роботів і який погано працював після перенесення на реальні машини. Цікаво, що простіші та більш обмежені політики краще переносилися на реальних роботів, ніж більші й гнучкіші, що суперечить поширеній у сфері штучного інтелекту інтуїції про перевагу великих моделей.
Автори вважають, що такий підхід робить навчання з підкріплення практичним інструментом для робототехніки. Це дозволяє розробникам тренувати рої для нових місій у симуляції та впевнено розгортати їх на реальних роботах — від пошуково-рятувальних робіт після землетрусів до моніторингу довкілля — у віртуальному просторі, не наражаючи при цьому на небезпеку справжню техніку.
«Що мене захоплює, так це те, що це робить навчання з підкріплення практичним інструментом для ройової робототехніки», — зазначив Ілієс Гарбі. Наступним кроком для команди стане тестування методу на більшій кількості роботів та в менш контрольованих умовах.
За матеріалами Robohub